|
Zhaonan LiI am a third-year Ph.D. student in Computer Science at ASU SCAI, advised by Prof. Ben Zhou. My research focuses on post-training of large language and vision-language models, including reinforcement learning and distillation for reasoning, compute-efficient training and inference, and robust multimodal reasoning. Previously, I was an applied research intern at Capital One and a research intern at the National Renewable Energy Laboratory (NREL). I received my B.S. (summa cum laude) in Computer Science and Applied Mathematics from Brandeis University and my M.S. in Computer Science from Columbia University. I am looking for research internships for Summer 2027. Email / Google Scholar / GitHub / LinkedIn / CV |
News |
|
Oct 2026
Our paper on adaptive decoding for token-efficient RL, from my Capital One internship, was accepted at the NeurIPS 2026 Workshop on Transitioning from Pre-training to Post-training. |
|
Sep 2026
Consistency-Driven Learning for Proof-Carrying Reasoning was accepted at AACL 2026. |
|
Aug 2026
Don’t Just Look, Intervene was accepted to Findings of EMNLP 2026. |
|
Jun 2026
Started a summer internship at Capital One as an Applied Research Intern. |
|
Apr 2026
VisAnalog was accepted as an oral at the CVPR 2026 Workshop on Visual Concepts. |
|
Aug 2025
QA-LIGN was accepted to Findings of EMNLP 2025. |
|
Jan 2025
One paper accepted at ICLR 2025 and one at NAACL 2025. |
Publications* equal contribution |
|
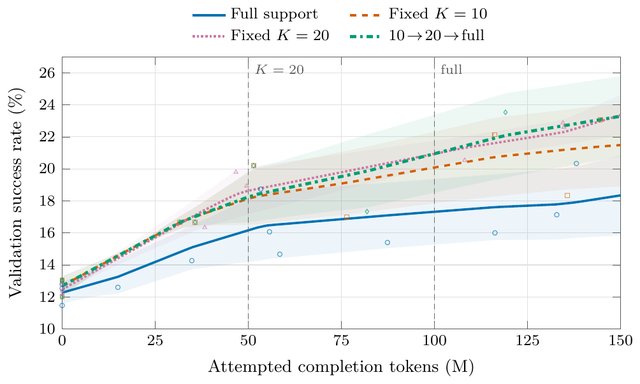
Adaptive Decoding Methods for Token-Efficient Reinforcement LearningZhaonan Li*, Zelei Cheng*, Amritansh Mishra*, Chia-Hsuan Lee, Mann Patel, Sambit Sahu, Ben Zhou, William M. Campbell NeurIPS 2026 Workshop on Transitioning from Pre-training to Post-training arXiv Work done during my internship at Capital One. |

|
Consistency-Driven Learning for Proof-Carrying ReasoningXiao Ye, Zhaonan Li, Jacob Dineen, Shijie Lu, Shaswat Shrivastava, Avneet Ahuja, Ming Shen, Zhikun Xu, Ben Zhou AACL 2026 arXiv The arXiv version is titled "CC-LEARN: Cohort-based Consistency Learning". |
|
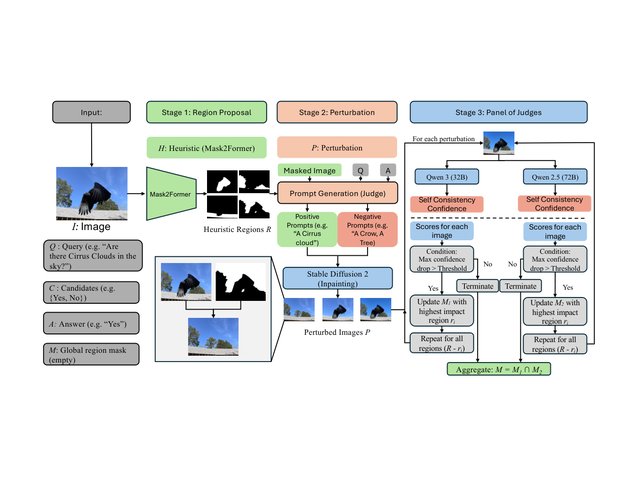
Don't Just Look, Intervene: Perturbation Based Region Labeling for VQA ImagesMarko Jojic, Zhaonan Li, Ben Zhou Findings of EMNLP 2026 arXiv |
|
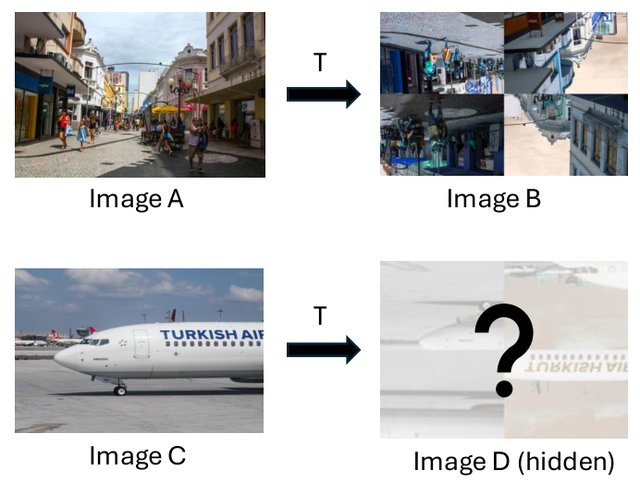
VisAnalog: A Diagnostic Suite for Visual Concept Transfer on Natural ImagesZhaonan Li, Kyle R. Chickering, Bangzheng Li, Jacob Dineen, Xiao Ye, Zhikun Xu, Shijie Lu, Yuxi Huang, Ming Shen, Bach Nguyen, Jaya Adithya Pavuluri, Mau Son Nguyen, Sanika Chavan, Ngoc Minh Thu Le, Muhao Chen, Ben Zhou CVPR 2026 Workshop on Visual Concepts Oral arXiv / dataset |

|
QA-LIGN: Aligning LLMs through Constitutionally Decomposed QAJacob Dineen, Aswin RRV, Qin Liu, Zhikun Xu, Xiao Ye, Ming Shen, Zhaonan Li, Shijie Lu, Chitta Baral, Muhao Chen, Ben Zhou Findings of EMNLP 2025 arXiv / paper |

|
ToW: Thoughts of Words Improve Reasoning in Large Language ModelsZhikun Xu*, Ming Shen*, Jacob Dineen, Zhaonan Li, Xiao Ye, Shijie Lu, Aswin RRV, Chitta Baral, Ben Zhou NAACL 2025 arXiv / paper / code |

|
SysCaps: Language Interfaces for Simulation Surrogates of Complex SystemsPatrick Emami, Zhaonan Li*, Saumya Sinha*, Truc Nguyen* ICLR 2025 arXiv / code |
Under Review & Preprints |
|
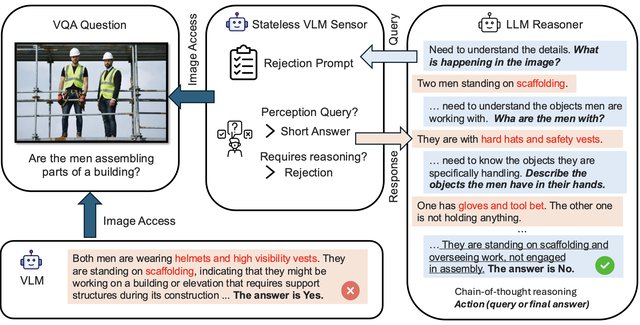
Decoupled Reasoning and Perception for Generalizable Visual ReasoningZhaonan Li*, Shijie Lu*, Fei Wang, Jacob Dineen, Xiao Ye, Zhikun Xu, Siyi Liu, Young Min Cho, Bangzheng Li, Daniel Chang, Kenny Nguyen, Qizheng Yang, Muhao Chen, Ben Zhou Under review at CVPR 2027 arXiv The arXiv version is titled "Unbiased Visual Reasoning with Controlled Visual Inputs". |
|
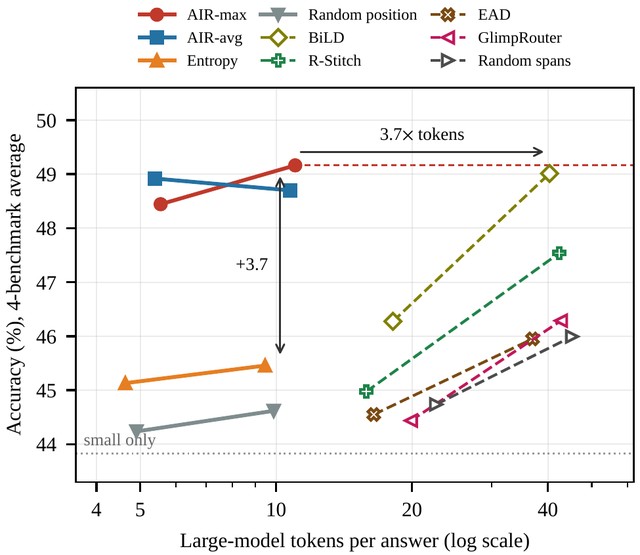
Beyond Entropy: Token-Level Routing via Answer ImpactZhaonan Li*, Xiao Ye*, Yunyi Zhang, Ben Zhou Under review at NAACL 2027 |
|
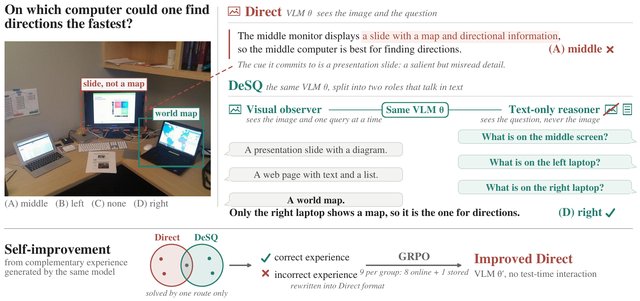
Self-Improving Vision-Language Models through Decoupled Self-QuestioningZhaonan Li, Ben Zhou Under review at NAACL 2027 |
|
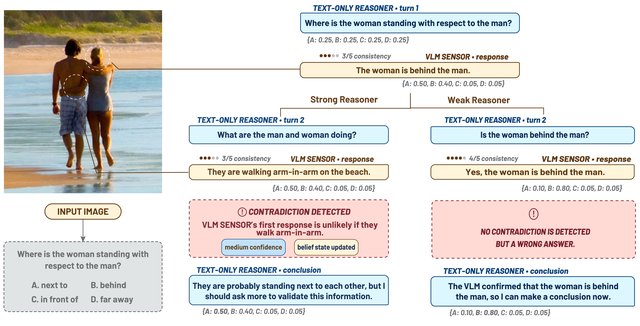
How Well Do LLMs Reason with Noisy Evidence? An Active Visual Reasoning BenchmarkBach Nguyen, Zhaonan Li, Mau Son Nguyen, Sanika Chavan, Nilay Kumar, Hong Anh Nguyen, Khoa Vo, Ben Zhou Under review at NAACL 2027 arXiv |
|
Evaluating Medical LLMs by Levels of Autonomy: A Survey Moving from Benchmarks to ApplicationsXiao Ye, Jacob Dineen, Zhaonan Li, Zhikun Xu, Weiyu Chen, Shijie Lu, Yuxi Huang, Ming Shen, Phu Tran, Ji-Eun Irene Yum, Muhammad Ali Khan, Muhammad Umar Afzal, Irbaz Bin Riaz, Ben Zhou arXiv preprint arXiv |
|
Zero-Knowledge Zero-Shot Learning for Novel Visual Category DiscoveryZhaonan Li, Hongfu Liu arXiv preprint arXiv |
|
Design and source code from Jon Barron's website |